Microsoft 365の大規模障害での学び
 rio
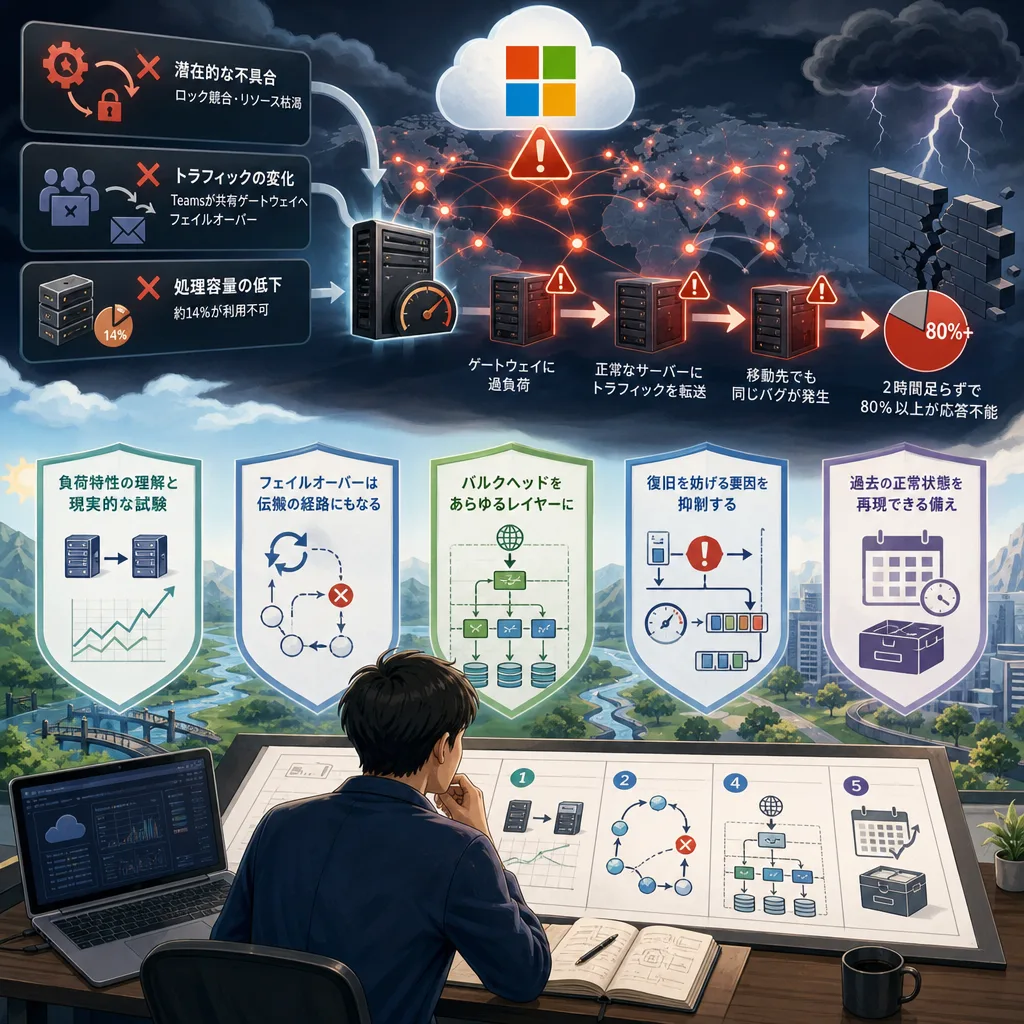
冗長化、自動フェイルオーバー、段階的デプロイを実装していても、それらの組み合わせによって大規模障害が発生し得る、という実例になっていて、さて、これは分解するとどういう設計指針に活かせるのかと考えてみた。
3つの要因による複合障害
Charles Lamanna氏による説明では、要因が3つあり、それらが揃ったことで発生したとみられます。
- 潜在的な不具合: 2026年7月に導入されたゲートウェイ専用の修正で、Windows内部プロセスにロック競合が生じる。特定の負荷条件でCPU・メモリが枯渇する。
- トラフィックの変化: Teamsが別系統のゲートウェイから、Exchange Onlineと共有するゲートウェイへ自動フェイルオーバーして、負荷とトラフィックの性質が変化した。
- 処理容量の低下: 別に発生していた問題が原因で、ゲートウェイのサーバー容量の約14%が利用できなかった。
ゲートウェイに過負荷がかかり応答が停止 → 正常なサーバーにトラフィックを転送 → 移動先でも同じバグが発生 → 大規模に連鎖
結果的に、2時間足らずで80%以上のサーバーが応答不能になり、通常時なら障害範囲を区切るバルクヘッドも別の問題で機能せず、世界規模に拡大した、というのが大まかな流れです。
5つの教訓
発生してみれば「そりゃそうだよなぁ」と思うものの、一見、常識と反するような事象も絡んでいたので、この大規模障害から5つの教訓を抜き出しました。個別の技術やコンポーネントではなく、考え方ですね。
1. 負荷試験では「低スペックなマシン」=「厳しい条件」とは限らない
今回、技術的に非常に興味深いのは、新しい高性能サーバーほどロック競合が悪化しやすかったことです。コア数を増やせば処理能力は上がり、その反対なら「厳しい条件」と考えがちですが、並列性が増えたときの振る舞いに注意が必要ということです。
例えば、4 vCPUのVMで十分な負荷試験を行い、32 vCPUのVMに移しても同じようにスケールすると考えるのは危険です。ロック、スレッドプール、GC、接続プールなどによって、スケーリング特性が変わることがあります。
Azure VM、AKS、Container Appsなどでアプリケーションを動かす時に、本番環境と同じ構成で同等の負荷をかけてみる必要があるということですね。
2. フェイルオーバーは、障害を伝搬させる経路にもなる
今回の障害で難しいなと思ったポイントがこれ。フェイルオーバーした先でも同じバグが発生しているということです。このバグは上記のロック競合なので、フェイルオーバー先で同じ処理能力を確保するだけでなく、流量制限や、過負荷時にサービスをデグレードし、影響範囲を限定する仕組みが必要ということになります。
重要なのは、Active-Activeやマルチリージョン構成であること自体は、共通原因による障害への耐性を保証しないという点です。
3. バルクヘッドはネットワークだけでは不十分。アプリのあらゆるレイヤーに必要
バルクヘッドパターンは、Azureアーキテクチャセンターでも説明されていますが、特定のレイヤーだけでは不十分だということが分かります。
自分の担当だと、Flexible ServerのPostgreSQLを複数のマイクロサービスで利用する場合が分かりやすい例です。マイクロサービスの1つがコネクションプールを大量消費すれば、他のマイクロサービスに影響します。
これを防ぐため、サービス単位の接続プール上限、同時実行数の上限、処理待ちキュー、ワークロードに応じたデータベース分離などを設計します。疎結合を設計の原則に取り入れるのも重要なことです。
リソース効率は下がりますが、障害の影響範囲を限定できることに意味があります。
4. 復旧を妨げる要因を抑制する
今回の障害が長引いた理由の一つに、滞留していた大量のメールのトラフィックによって、再び応答不能になったことが挙げられます。
これもAzureアーキテクチャーセンターにあって、Retry Storm AntipatternとCircuit Breaker Patternです。
| 通常時に有効な機構 | 障害時に起こり得る問題 |
|---|---|
| 自動リトライ | リクエスト数が増え、復旧を妨げる |
| 自動フェイルオーバー | 正常なシステムまで過負荷にする |
| オートスケーリング | 下流のDBなどにさらに負荷を集中させる |
| キューによるバッファリング | 復旧後に大量の処理が一気に流れる |
指数バックオフ+Jitterは、コネクションのリトライでよく使われるので知っている人も多いはず。リトライ数に上限を設けることもよくやりますね。あとは、Circuit Breaker、Backpressureを組み合わせる感じです。
Azure Service Busなどで処理を非同期化する場合も、キューの保持容量だけでなく、コンシューマー側の処理速度の上限を管理することが重要です。
5. 3ヶ月前の変更が原因=ロールバックが役立たない
これ、「ひぇぇ」ってなります。直近の変更が原因では無く、顕在化していない、眠っていた不具合が原因というパターン。
ここから得られる教訓は、デプロイ時の安全性だけではありません。
既知の正常な状態をどの程度の期間、再現可能な状態で維持できるかも重要です。
コンテナイメージやVMイメージ、IaC、設定のバージョンを適切に保持し、過去の組み合わせを再展開できる仕組みが必要という意味になります。もう古いやつだから消しちゃえ、という運用はダメってことですね…(自宅鯖でやりがち)。
あと、データベースのスキーマ変更では、アプリケーションだけを古いバージョンに戻せないこともあるため、後方互換性を含めた変更管理が必要ですね。
WAFに当てはめる
AzureにはWell-Architected Framework・WAFという設計原則があります。今回の教訓を当てはめて見直すべき項目をまとめると、以下のようになります。
| 分野 | 特に見直すべき項目 |
|---|---|
| Reliability | Fault Isolation、Bulkhead、Graceful Degradation、障害時の自己保護 |
| Performance Efficiency | 実際の負荷特性、容量計画、スケールの限界、リソース競合 |
| Operational Excellence | Safe Deployment、Observability、復旧手順、変更管理 |
| Resilience Testing | 複合障害、復旧時の流量、障害注入試験 |
まとめ
今回の障害で特に印象的なのは、既に、異種の独立したゲートウェイ、段階的デプロイ、容量の余裕、自動フェイルオーバー、障害隔離の仕組みを持っていたのに、それでも大規模障害が発生しました。
ここから3つの設計思想が導けます。
- 冗長性は必要ですが、それだけで耐障害性は完成しません。
- 切り替え可能であることより、切り替えた先で安全に処理できることが重要です。
- 障害に耐える設計と、障害から復旧する設計は別物です。
設計の際に忘れないようにしたいですね。